Traditional SDLC
SDLC = Software Development Life Cycle,即软件开发生命周期,其描述的是一个软件系统从一个idea –> 需求确定 –> 设计 –> 编码 –> 测试 –> 最终上线 –> 维护的完整过程
引入SDLC的关键目的是:将软件开发从零散的活动转化为可规划、可管理、可验证的工程过程。SDLC 本身是一个生命周期框架,描述软件从构想到退役所经历的主要活动。
Traditional SDLC工作流
传统软件开发实践经常采用瀑布式流程,因此 Traditional SDLC 常与 Waterfall 联系在一起。但二者并不等同:SDLC 描述软件生命周期中需要完成哪些活动,Waterfall 则规定这些活动如何按阶段顺序推进。下面则是一个完整的SDLC流程图:
%%{init: {"htmlLabels": false, "flowchart": {"padding": 30}, "fontFamily": "Arial, sans-serif"}}%%
flowchart TD
    A["Planning - 项目规划"]
    B["Feasibility Study - 可行性分析"]
    C["Requirements Analysis - 需求分析"]
    D["System Design - 系统设计"]
    E["Implementation - 编码实现"]
    F["Testing - 系统测试"]
    G["Deployment - 系统部署"]
    H["Maintenance - 运行维护"]

    A --> B
    B --> C
    C --> D
    D --> E
    E --> F
    F --> G
    G --> H

    style A fill:#DBEAFE,stroke:#2563EB,color:#1E3A8A
    style B fill:#DBEAFE,stroke:#2563EB,color:#1E3A8A
    style C fill:#E0E7FF,stroke:#4F46E5,color:#312E81
    style D fill:#E0E7FF,stroke:#4F46E5,color:#312E81
    style E fill:#DCFCE7,stroke:#16A34A,color:#166534
    style F fill:#FEF3C7,stroke:#D97706,color:#92400E
    style G fill:#F3E8FF,stroke:#9333EA,color:#6B21A8
    style H fill:#F3E8FF,stroke:#9333EA,color:#6B21A8
这里需要区分三个概念:
- SDLC 是描述软件生命周期活动的总体框架;
- Waterfall 是一种强调阶段顺序和阶段交付的软件开发模型;
- Secure SDLC(SSDLC) 是将安全需求、威胁建模、安全编码、安全测试和安全运营等活动融入整个软件生命周期的方法。
从安全从业者的视角来看,更需要关注安全活动如何嵌入软件生命周期,即 Secure SDLC。
Requirements Analysis(需求分析)
为了进一步说明安全活动如何嵌入 SDLC,下面先从需求分析阶段展开。需求阶段决定了系统需要保护什么、需要抵御哪些风险,以及后续设计、开发和测试应满足哪些安全目标。
Requirements Analysis是理解软件安全问题如何产生的重要起点因为安全问题不一定始于编码阶段,也可能来自更早的需求和设计缺陷,所以Secue SDLC从需求阶段开始融入安全活动–将威胁和风险转化为正式安全需求。
安全需求从何而来?
法律法规与合规的需求:国家法律、行业法规、监管要求中明确规定的安全措施
业务安全需求:业务本身需要的安全能力,保护业务正常运行
历史漏洞与事件:过去发生过的安全漏洞和事件,总结出来的安全需求
风险分析与威胁场景:根据攻击面、威胁主体和潜在影响形成的安全需求;
在形成正式需求之前,可以先按照安全能力维度对需求进行归类。以下分类用于帮助识别需求,不代表完整的安全能力体系。
| 类别 | 说明 | 典型需求 |
|---|---|---|
| 身份认证(Authentication) | 验证用户是谁 | 用户名密码登录、手机验证码登录、多因素认证(MFA)、单点登录(SSO) |
| 授权与访问控制(Authorization) | 验证用户能做什么 | 角色权限管理(RBAC)、数据权限控制、接口鉴权、越权防护 |
| 数据安全(Data Security) | 保护数据的机密性、完整性、可用性 | 敏感数据加密存储、传输加密(HTTPS)、数据脱敏、数据备份 |
| 审计与日志(Audit & Logging) | 记录关键操作,可追溯 | 用户登录日志、操作审计日志、异常行为告警、日志留存期限 |
| 可用性与韧性(Availability) | 保证系统持续可用 | 防DDoS攻击、限流熔断、容灾备份、故障恢复 |
| 会话安全(Session Security) | 保护用户会话安全 | 会话超时、会话固定防护、CSRF防护、安全Cookie |
| 输入输出安全(Input/Output) | 防止恶意输入和输出泄露 | 输入校验、输出编码、文件上传安全、防SQL注入/XSS |
举个例子:
安全目标是防止攻击者接管管理员账户
安全能力是多因素认证
正式需求则是所有后台管理员账户必须启用MFA
安全需求的SMART原则:
S:具体明确,不模糊
M:可衡量,能验证是否满足
A:可实现,不是天方夜谭
R:相关,和业务场景匹配
T:有时限,什么时候完成
除了识别具体的安全能力,需求阶段通常还需要开展数据分类分级、数据流梳理和合规评估。这些活动的结果会进一步转化为安全需求。
数据分类是按照数据的内容、来源和业务用途识别数据类型;数据分级则根据数据的敏感程度、重要程度以及泄露、篡改或丢失后的影响确定保护等级。具体分级方式应以适用的法律法规、行业标准和组织内部制度为准,不一定统一采用 L1–L4 模型。在完成分类分级后,还需要梳理数据的采集、传输、存储、使用、共享和删除过程,形成数据流图,为后续的合规评估和威胁建模提供输入。
合规评估主要看产品是否涉及个人信息,是否涉及重要数据,是否属于关键信息基础设施,以及是否满足行业特殊的合规要求等
需求阶段的主要安全交付物
- 安全需求清单;
- 每条需求对应的验收标准;
- 数据资产清单和分类分级结果;
- 数据流图;
- 合规要求清单;
- 初步风险清单;
- 需求来源、负责人和优先级。
需求分析阶段的重点,不是立即决定所有安全技术方案,而是明确系统需要保护什么、需要满足哪些约束,以及后续如何验证这些要求已经得到落实。
System Design(系统设计)
上一个阶段重点在如何通过业务分析、资产识别、风险识别,将潜在问题转化为具体的Security Requirements(安全需求)。
系统设计这一阶段,对于安全工程师非常重要,因为很多漏洞并不完全是代码写错造成的,而是系统在设计之初就存在安全缺陷。
例如:
系统没有合理设计用户权限模型,导致水平越权或垂直越权。
内部服务默认信任其他服务的请求,导致身份冒用和未授权访问。而系统设计,就是把需求分析阶段明确的系统需求,转化为可实施的技术设计方案的过程。需求阶段确定了”要什么安全”,设计阶段就要确定”怎么实现安全”。
System Design可以划分为HLD和LLD
HLD:从整体架构寻找风险
假设公司开发一套安全告警管理平台,业务功能包括WAF告警接入、主机告警接入、告警研判、告警处置和报表生成,架构师提出以下系统架构:
flowchart TB
    U["安全分析师"]
    W["WAF设备"]
    H["HIDS设备"]
    API["业务API"]
    ING["告警采集服务"]
    PROC["告警处理服务"]
    DB[("告警数据库")]
    LOG[("审计日志")]

    U --> API
    W --> ING
    H --> ING
    ING --> PROC
    PROC --> DB
    API --> DB
    API --> LOG
    PROC --> LOG

    style API fill:#DBEAFE,stroke:#2563EB
    style ING fill:#DBEAFE,stroke:#2563EB
    style PROC fill:#DBEAFE,stroke:#2563EB
    style DB fill:#DCFCE7,stroke:#16A34A
    style LOG fill:#DCFCE7,stroke:#16A34A
从安全工程师视角看到这张图,首先需要关注
| 设计对象 | 安全工程师需要确认的问题 |
|---|---|
| 业务 API | 是否进行身份认证和资源级授权? |
| 告警采集服务 | 如何确认告警数据确实来自合法设备? |
| 告警处理服务 | 是否会把不可信的告警内容当作命令或代码执行? |
| 告警数据库 | 数据库账号是否遵循最小权限原则? |
| 审计日志 | 日志能否被业务操作人员篡改? |
| 组件间通信 | 是否存在明文传输及未经认证的服务调用? |
在HLD阶段已经能够通过架构审查潜在攻击面,但是还不能直接下结论说系统存在漏洞,因为架构图没有展示所有的安全措施。
LLD:深入具体功能的安全设计
假设系统提供一个修改告警状态的API:
PATCH /api/alerts/1001 HTTP/1.1
Content-Type: application/json
Authorization: Bearer <token>

{
  "status": "false_positive"
}
安全需求提出:SR-AC-001:用户只能修改其授权范围内的告警状态。
那么在LLD阶段,需要把这条需求转化为具体的技术设计
flowchart TD
    A["收到修改请求"]
    B["验证用户身份"]
    C{"身份有效"}
    D["获取资源与权限"]
    E{"具有操作权限"}
    F["执行状态更新"]
    G["记录审计日志"]
    H["拒绝请求"]

    A --> B
    B --> C
    C -->|否| H
    C -->|是| D
    D --> E
    E -->|否| H
    E -->|是| F
    F --> G
可以很明显的看到HLD关注系统整体的安全结构(宏观);LLD关注具体模块与操作的安全机制。(细节)
安全设计原则
系统阶段将安全需求转化为具体的安全实现方案对应需要遵守一系列原则
最小权限原则:每个主体(用户、进程、服务、系统)只拥有完成其任务所必需的最小权限,不多给任何多余的权限。
纵深防御原则:建立多层安全防护机制,一层被攻破了还有下一层,不会因为单一防护失效就导致整个系统沦陷。
默认安全原则:系统的默认配置就是安全的,用户不需要额外配置就能获得基本的安全保障。
职责分离原则:关键操作需要不同角色分别完成,不能由一个人独立完成,防止单点风险和内部欺诈。
零信任原则:不信任任何外部输入,也不信任内部其他模块的输出,所有数据和请求都要经过验证才能使用。
可审计原则:所有关键操作都要有日志记录,能够追溯”谁在什么时间做了什么操作,结果如何”,出了问题能查清楚。
Threat Modeling(威胁建模)
威胁建模是系统设计阶段的一项重要安全活动,是一种结系统地分析系统可能面临的安全威胁,评估风险等级,并制定相应防护措施的过程。
通常威胁建模需要多方参与
架构师/技术负责人:最了解系统架构,能讲清楚系统怎么工作
开发工程师:了解具体实现细节
安全工程师:主导威胁建模,提供安全专业知识,引导分析过程
在正式识别威胁之前,安全工程师通常需要建立数据流图/系统架构图,明确系统有那些组件,组件之间怎么交互,数据怎么流动。
架构图需要包含的要素:
- 外部实体:用户、第三方系统、管理员等系统外部的角色
- 系统组件:Web前端、API网关、应用服务、数据库、缓存、消息队列等
- 数据流:组件之间的数据传输,用箭头表示方向,标注传输的数据内容
- 信任边界:可信区域和不可信区域的分界线
这里重点提一下信任边界,它是指可信区域和不可信区域之间的分界线。在信任边界的一侧,数据是可信的;在另一侧,数据是不可信的。威胁最容易出现在信任边界上,当数据从不可信区域进入可信区域时,如果没有做好验证,就会引入安全威胁。
flowchart TD
    U["安全分析师"]
    W["WAF 安全设备"]
    H["HIDS 安全设备"]

    subgraph TB1["信任边界 A:业务应用区域"]
        API["P1:业务 API 服务"]
        ING["P2:告警采集服务"]
        PROC["P3:告警处理服务"]
        AUTH["P4:身份认证与授权服务"]
    end

    subgraph TB2["信任边界 B:数据存储区域"]
        DB[("D1:告警数据库")]
        LOG[("D2:审计日志存储")]
    end

    U -->|"F1:查询告警与修改状态"| API
    API -->|"F2:响应数据"| U

    W -->|"F3:WAF 告警数据"| ING
    H -->|"F4:HIDS 告警数据"| ING

    API -->|"F5:认证与授权请求"| AUTH
    AUTH -->|"F6:验证结果"| API

    ING -->|"F7:标准化告警"| PROC
    PROC -->|"F8:告警入库"| DB

    API <-->|"F9:查询与更新告警"| DB

    API -->|"F10:操作审计事件"| LOG
    PROC -->|"F11:处理审计事件"| LOG

    classDef external fill:#FEF3C7,stroke:#D97706,color:#92400E
    classDef process fill:#DBEAFE,stroke:#2563EB,color:#1E3A8A
    classDef storage fill:#DCFCE7,stroke:#16A34A,color:#166534

    class U,W,H external
    class API,ING,PROC,AUTH process
    class DB,LOG storage

    style TB1 fill:#EFF6FF,stroke:#3B82F6,stroke-width:2px,stroke-dasharray:5 5
    style TB2 fill:#F0FDF4,stroke:#16A34A,stroke-width:2px,stroke-dasharray:5 5
进行威胁建模的时候一般采用STRIDE模型进行分析
| STRIDE | 威胁类型 | 安全场景 |
|---|---|---|
| S — Spoofing | 身份伪造 | 攻击者伪造设备身份提交告警 |
| T — Tampering | 数据篡改 | 非法修改告警处置状态 |
| R — Repudiation | 抵赖 | 用户修改告警后否认自己执行过操作 |
| I — Information Disclosure | 信息泄露 | 越权读取其他业务的告警 |
| D — Denial of Service | 拒绝服务 | 大量告警导致处理队列积压、服务不可用 |
| E — Elevation of Privilege | 权限提升 | 普通用户获得管理员级操作能力 |
F1:安全分析师 → 业务 API
潜在威胁:Spoofing、Elevation of Privilege、Tampering。
检查用户身份认证、资源级权限校验,避免水平越权和非法状态修改。
F3 / F4:安全设备 → 告警采集服务
潜在威胁:Spoofing、Tampering、Denial of Service。
检查设备身份认证、传输完整性、数据校验及接口限流。
F9:业务 API ↔ 告警数据库
潜在威胁:Information Disclosure、Tampering。
检查数据库账户权限、参数化查询、敏感数据访问控制。
F10 / F11:业务服务 → 审计日志
潜在威胁:Repudiation、Tampering。
检查关键操作是否被记录,日志是否能够被非法删除或修改。
枚举完威胁后,需要评估每个威胁的风险等级
| 数据流 / 威胁 | 潜在安全事件 | L | I | 风险等级 |
|---|---|---|---|---|
| F1 — Spoofing | 攻击者冒用分析师身份访问告警 | 2 | 3 | 高 6 |
| F1 — Elevation of Privilege | 普通用户越权操作其他业务组告警或执行管理员操作 | 2 | 3 | 高 6 |
| F1 — Tampering | 未授权修改告警状态,隐藏真实攻击 | 2 | 3 | 高 6 |
| F3/F4 — Spoofing | 伪造 WAF/HIDS 设备身份提交虚假告警 | 2 | 3 | 高 6 |
| F3/F4 — Tampering | 篡改告警数据,影响安全事件研判结果 | 2 | 3 | 高 6 |
| F3/F4 — Denial of Service | 大量异常告警导致采集队列积压、服务不可用 | 2 | 2 | 中 4 |
| F9 — Information Disclosure | 非法查询数据库,泄露资产及安全告警信息 | 2 | 3 | 高 6 |
| F9 — Tampering | 通过应用缺陷非法篡改或删除告警记录 | 2 | 3 | 高 6 |
| F10/F11 — Repudiation | 审计事件缺失,导致操作行为无法追溯 | 2 | 2 | 中 4 |
| F10/F11 — Tampering | 非法修改或删除审计日志,破坏证据完整性 | 2 | 3 | 高 6 |
最后针对高风险和严重风险的威胁,制定缓解措施
| 威胁编号 | 威胁类型 | 具体缓解措施 |
|---|---|---|
| F1-S | Spoofing 身份伪造 | 接入统一身份认证(SSO)、管理员 MFA、强化 Session/Token 管理,限制异常登录行为 |
| F1-E | Elevation of Privilege 权限提升 | 建立 RBAC/ABAC 权限模型,实施服务端对象级授权,默认拒绝未授权操作 |
| F1-T | Tampering 数据篡改 | 校验告警修改权限与状态流转规则,对敏感批量操作增加审批或二次确认,记录完整变更日志 |
| F3/F4-S | Spoofing 设备身份伪造 | 使用 mTLS 或设备专属签名凭证认证设备,实施凭证轮换、撤销和来源访问控制 |
| F3/F4-T | Tampering 告警数据篡改 | 使用 TLS 保护传输,对需要端到端完整性保护的消息进行签名验证,保留原始告警和处理记录 |
| F9-I | Information Disclosure 信息泄露 | 实施服务端数据授权、参数化查询、数据库最小权限、敏感数据加密和访问审计 |
| F9-T | Tampering 数据篡改 | 限制数据库写入权限,校验业务更新操作,启用事务、数据变更审计和备份恢复机制 |
| F10/F11-T | Tampering 日志篡改 | 将审计日志集中存储,隔离日志写入与管理权限,使用追加写入、防篡改存储及完整性检测 |
安全设计评估
在系统设计完成后、编码开始前,需要由安全工程师和相关方一起,对设计方案进行安全审查,评估设计是否满足安全需求、是否存在安全风险。
安全设计评审检查清单:
| 类别 | 检查项 |
|---|---|
| 身份认证 | 是否有明确的认证机制?是否支持多因素认证?密码策略是否合理?Token机制是否安全? |
| 授权与访问控制 | 是否有明确的权限模型?是否遵循最小权限原则?是否有越权防护?数据权限是否控制? |
| 数据安全 | 敏感数据是否加密存储?传输是否加密?是否有数据脱敏?数据备份和销毁策略? |
| 输入输出安全 | 所有输入是否校验?输出是否编码?是否有SQL注入/XSS防护?文件上传是否安全? |
| 会话管理 | 会话超时设置?会话固定防护?CSRF防护?Cookie安全属性? |
| 审计与日志 | 关键操作是否记录日志?日志是否包含必要信息?日志是否安全存储?留存期限? |
| 可用性 | 是否有限流熔断机制?是否防DDoS?是否有容灾备份?故障恢复方案? |
| 第三方安全 | 第三方组件是否评估?第三方接口是否鉴权?第三方数据是否校验? |
| 合规要求 | 是否满足相关法律法规?个人信息保护是否合规?等保要求是否满足? |
Implementation(编码实现)
implementation,也称Coding或Development,主要目标是将系统设计阶段确定的架构、模块、接口和业务逻辑转化为可运行的软件。
从安全工程师角度看,该阶段的核心目标是:确保开发人员按照安全设计要求实现代码,同时防止编码过程中引入新的安全漏洞。
传统开发过程中,开发团队通常先领取任务、编写代码、进行测试,再将代码集成到项目中。将安全融入这个阶段后,就形成了以下工作流程。
flowchart TD
    A["获取需求和设计"]
    B["制定安全编码规范"]
    C["开发人员编写代码"]
    D["安全单元测试"]
    E["SAST 静态代码扫描"]
    F["SCA 依赖组件检查"]
    G["代码安全审查"]
    H{"安全检查通过"}
    I["修复安全问题"]
    J["合并代码"]
    K["进入系统测试"]

    A --> B
    B --> C
    C --> D
    D --> E
    E --> F
    F --> G
    G --> H
    H -->|否| I
    I --> C
    H -->|是| J
    J --> K

    classDef normal fill:#DBEAFE,stroke:#2563EB,color:#1E3A8A
    classDef security fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef risk fill:#FEF3C7,stroke:#D97706,color:#92400E

    class A,B,C,J,K normal
    class D,E,F,G security
    class H,I risk
该阶段的三个核心工作:
Secure Coding(安全编码):从源头减少容易产生安全漏洞的代码实现
Secure Code Review(安全代码审查):检查关键模块、权限逻辑和数据流中的安全缺陷
Automated Security Analysis(自动化安全分析):使用SAST、SCA、Secrets Scanning等技术辅助发现潜在安全问题。
Secure Coding
Secure Coding主要是让开发人员在编写软件时遵循安全编码规范,从而降低引入安全漏洞的可能性。
典型例子就是SQL注入,SQL注入的根本原因之一,是程序将不可信输入拼接进SQL语句,使输入内容有机会影响SQL的语法结构。
def search_alerts(conn, keyword):
    sql = (
        "SELECT * FROM alerts "
        f"WHERE title LIKE '%{keyword}%'"
    )
    return conn.execute(sql).fetchall()
这里的keyword直接进入了SQL语,如果用户输入包含SQL特殊字符或语法结构,就可能改变原本的查询逻辑。所以在安全编码阶段,应当使用参数化查询来规避安全风险。
def search_alerts(conn, keyword):
    sql = """
        SELECT id, title, severity
        FROM alerts
        WHERE title LIKE ?
    """
    return conn.execute(
        sql, (f"%{keyword}%",)
    ).fetchall()
这里列举一些常见的安全编码问题
| 漏洞类型 | 常见不安全实现 | 安全编码措施 |
|---|---|---|
| SQL Injection | 动态拼接 SQL | 参数化查询 |
| XSS | 不可信数据直接插入 HTML | 按输出上下文编码、安全 DOM API |
| Command Injection | 用户输入直接拼接 Shell 命令 | 避免 Shell 拼接,使用安全 API |
| SSRF | 服务端任意请求用户提供的 URL | 目标校验、网络出口限制 |
| Path Traversal | 用户输入直接作为文件路径 | 路径规范化与允许范围校验 |
| Broken Access Control | 只检查登录,不检查资源权限 | 服务端逐请求授权 |
| Sensitive Data Exposure | 明文存储敏感凭证 | 安全凭证管理、加密及权限控制 |
| Insecure Deserialization | 反序列化不可信对象 | 避免危险反序列化机制、限制数据格式 |
Secure Code Review
在编码完成到版本发布之前需要经过多次的review,代码审计则是在该过程中针对开发提交的源码进行审计发现潜在的安全缺陷。
代码审计中,经常会使用两个概念,Source to Sink
Source(污染源):用户输入、HTTP Header、请求参数、第三方数据
Data Flow(数据传播):赋值、参数传递、函数调用、数据调用
Sink(敏感操作点):SQL 执行、系统命令执行、文件读取、HTML 输出
keyword = request.args.get("keyword")

sql = "SELECT * FROM alerts WHERE title = '" \
      + keyword + "'"

cursor.execute(sql)| 对象 | 对应代码 | 安全意义 |
|---|---|---|
| Source | request.args.get() | 获取用户可控输入 |
| Data Flow | 字符串拼接 | 不可信数据进入 SQL 字符串 |
| Sink | cursor.execute() | 执行数据库查询 |
Automated Security Analysis
该阶段经常设计一些自动化的安全检测工具:SAST、SCA、DAST
SAST-静态应用安全测试:不需要运行完整应用,通过分析源码、字节码或其他程序表示发现潜在安全问题
SCA-软件成分分析:重点分析项目使用的第三方依赖以及其他传递依赖,识别已知漏洞、组件版本和其他供应链风险。
DAST-动态应用安全测试:面向运行中的应用,通过发送请求、分析响应等方式发现潜在漏洞
工具在CI/CD中的集成
| 阶段 | 安全工具 | 说明 |
|---|---|---|
| 编码阶段 | IDE安全插件(SonarLint等) | 写代码时实时提示安全问题,发现即修复 |
| 代码提交 | Git钩子(pre-commit) | 提交代码前自动做轻量安全检查,如密钥扫描 |
| 代码合并 | SAST + SCA | MR/PR时自动触发SAST和SCA扫描,发现漏洞阻塞合并 |
| 构建阶段 | SAST + SCA + 镜像扫描 | 构建时做完整的代码扫描和组件扫描,容器镜像做安全扫描 |
| 测试阶段 | DAST + IAST | 测试环境部署后,自动做动态安全扫描 |
| 发布阶段 | 安全门禁(Quality Gate) | 设置安全门禁,高危漏洞未修复不允许发布 |
| 运行阶段 | 持续监控 + RASP | 运行时持续监控安全状态,RASP实时防护 |
安全门禁是CI/CD集成的核心,通过设置安全阈值,不满足条件的构建不允许发布。这样把安全质量变成了发布的硬性条件,确保带高危漏洞的代码不会上线。
Testing(系统测试)Deployment & Maintenance(部署与维护)
系统测试阶段则需要针对完成编码上线的系统进行生产环境下的测试,也就是我们常说的渗透测试。这个不多说了。
部署阶段则是将经过测试和批准的软件版本发布到目标环境,完成生产配置、服务上线与上线验证。安全目标:确保部署的软件、配置、运行环境及发布流程符合安全要求。
维护阶段系统上线后,通过监控、漏洞管理、补丁更新、应急响应等方式,持续维持系统的安全性和可靠性。安全目标:识别并处理运行过程中不断变化的安全风险。
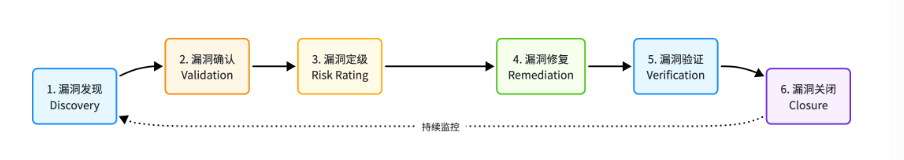
漏洞管理体系
一个完整的漏洞管理通常包括6个环节,形成一个闭环